k8s故障场景
1.亲和性规则冲突
1.排查问题
kubectl describe pods

2.查看evtens字段
Events:
  Type     Reason            Age   From               Message
  ----     ------            ----  ----               -------
  Warning  FailedScheduling  103s  default-scheduler  0/3 nodes are available: 1 node(s) had untolerated taint {node-role.kubernetes.io/control-plane: }, 2 node(s) didn't match Pod's node affinity/selector. preemption: 0/3 nodes are available: 3 Preemption is not helpful for scheduling.

  警告  调度失败  103秒前  默认调度器 3个节点均不可用:
  - 一个节点无法容忍的五点(污点键:node-role.kubernetes.io/control-plane)
  - 2个节点不匹配pod的亲和性/选择器

抢占调度:0/3个节点可用,抢占对当前调度无帮助

3.查看pod的资源清单
kubectl get pod <pod-name> -o yaml |grep -A 10 "affinity\|nodeSelector"
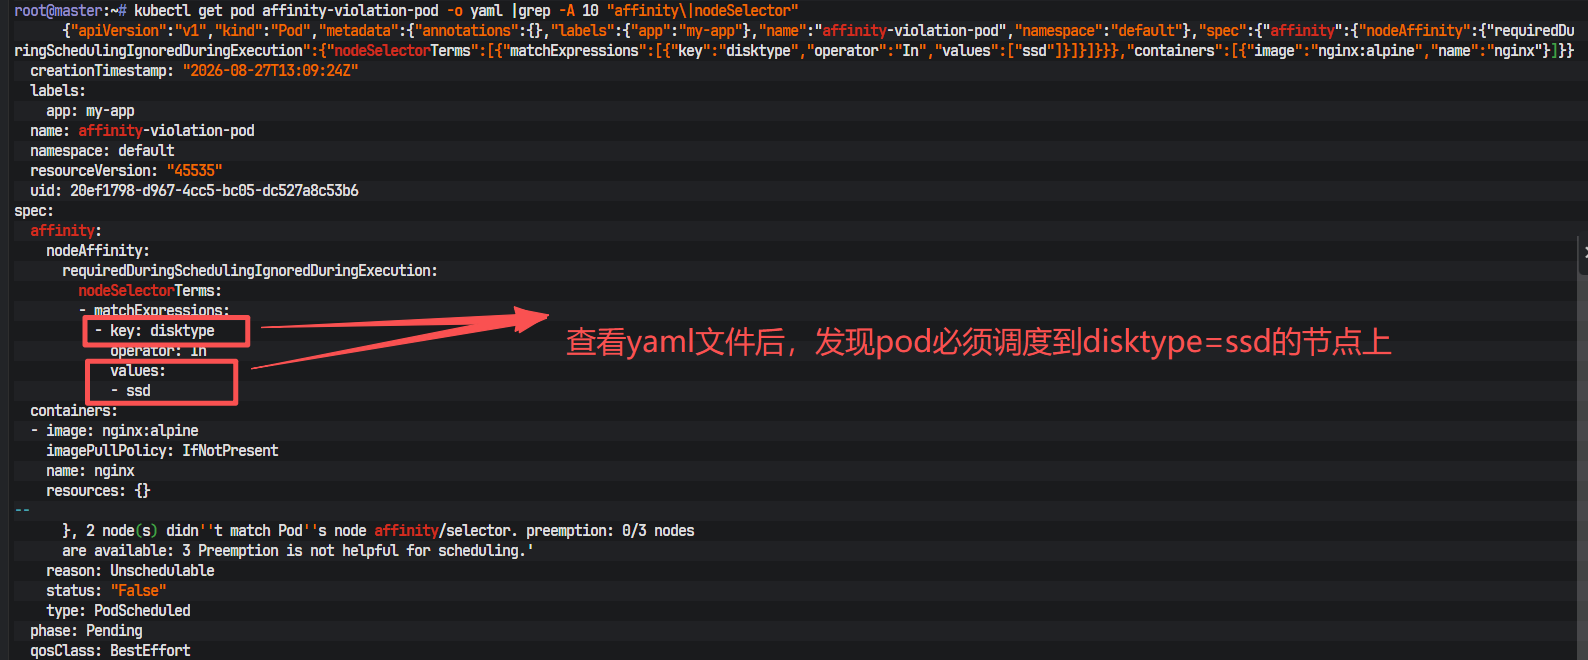
4.查看node节点是否存在disktype这个节点
kubectl get nodes --show-labels
NAME      STATUS   ROLES           AGE   VERSION    LABELS
master    Ready    control-plane   20d   v1.32.13   beta.kubernetes.io/arch=amd64,beta.kubernetes.io/os=linux,kubernetes.io/arch=amd64,kubernetes.io/hostname=master,kubernetes.io/os=linux,node-role.kubernetes.io/control-plane=,node.kubernetes.io/exclude-from-external-load-balancers=
worker1   Ready    <none>          20d   v1.32.13   beta.kubernetes.io/arch=amd64,beta.kubernetes.io/os=linux,kubernetes.io/arch=amd64,kubernetes.io/hostname=worker1,kubernetes.io/os=linux
worker2   Ready    <none>          20d   v1.32.13   beta.kubernetes.io/arch=amd64,beta.kubernetes.io/os=linux,kubernetes.io/arch=amd64,kubernetes.io/hostname=worker2,kubernetes.io/os=linux

并没有这个disktype这个标签,所有3个节点都无法创建pod
2.DNS解析失败
1.查看节点状态
kubectl get node -o wide

2.查看pod详细信息
kubectl describe pods

3.查看pod日志
kubectl logs dns-failure-pod

报错信息
;; connection timed out; no servers could be reached
显示无法到达任何服务器


根据报错信息得到,是容器内部的dns解析问题,进入容器内部查看解析
root@master:~# kubectl exec -it dns-failure-pod -- /bin/sh
/etc # cat /etc/resolv.conf
nameserver 192.0.2.1

/etc # ping 192.0.2.1
PING 192.0.2.1 (192.0.2.1): 56 data bytes
^C
--- 192.0.2.1 ping statistics ---
5 packets transmitted, 0 packets received, 100% packet loss

ping指向的IP 192.0.2.1 无法ping通

4.查看pod对应的yaml文件
root@master:~# kubectl get pod dns-failure-pod -o yaml

5.根据pod名查看Pod yaml文件对应的位置
root@master:~# grep -r "name: dns-failure-pod" .
./kubernetes-like-a-pro/troubleshoot-kubernetes-like-a-pro/scenarios/dns-resolution-failure/issue.yaml:  name: dns-failure-pod

6.修改pod yaml中192.0.2.1的ip地址,将ip改为对应svc的ip
	查看对应svc的ip
	root@master:~# kubectl get svc -n kube-system |grep dns
kube-dns         ClusterIP   10.96.0.10      <none>        53/UDP,53/TCP,9153/TCP   20d

7.删除pod并新建pod后查看pod日志显示正常
kubectl delete dns-failure-pod
kubectl apply -f 查询到的yaml文件地址
3.资源不足
1.查看pod状态
kubectl get pods -o wide
NAME                         READY   STATUS    RESTARTS   AGE   IP       NODE     NOMINATED NODE   READINESS GATES
insufficient-resources-pod   0/1     Pending   0          89s   <none>   <none>   <none>           <none>

pod处于pending状态

2.查看详细信息
kubectl describe pods insufficient-resources-pod

Events:
  Type     Reason            Age    From               Message
  ----     ------            ----   ----               -------
  Warning  FailedScheduling  2m45s  default-scheduler  0/3 nodes are available: 1 node(s) had untolerated taint {node-role.kubernetes.io/control-plane: }, 2 Insufficient memory. preemption: 0/3 nodes are available: 1 Preemption is not helpful for scheduling, 2 No preemption victims found for incoming pod.

  警告 pod调度失败 2m45s前 默认调度器 3个节点均不可用 1 个节点存在无法容忍的污点(污点键:`node-role.kubernetes.io/control-plane`) 2个节点不匹配Pod的节点亲和性/选择器 抢占调度:0/3个节点可用
  3个节点均无法通过抢占来解决调度问题


3.查看pod对应yaml文件请求的资源数量
root@master:~# kubectl get pod insufficient-resources-pod -o yaml | grep -A 5 "resources:"
    resources:
      requests:
        cpu: "2"
        memory: 4Gi
    terminationMessagePath: /dev/termination-log
    terminationMessagePolicy: File

请求4g内存,而2个worker节点和1个master的内存都只有4g,所有无法创建pod,物理机器的资源不够pod请求,必须修改对应的资源清单

4.删除pod并重建pod
root@master:~# kubectl delete pods insufficient-resources-pod
root@master:~# kubectl apply -f kubernetes-like-a-pro/troubleshoot-kubernetes-like-a-pro/scenarios/insufficient-resources/issue.yaml
4.k8s版本过旧
5.安全上下文问题
root@master:~/kubernetes-like-a-pro/troubleshoot-kubernetes-like-a-pro/scenarios/security-context-issues# ll
total 24
drwxr-xr-x  2 root root 4096 Apr  7 14:27 ./
drwxrwxr-x 37 root root 4096 Apr  7 14:27 ../
-rw-rw-r--  1 root root  539 Aug 27 12:18 description.md
-rw-rw-r--  1 root root  306 Apr  7 14:27 fix.yaml
-rw-rw-r--  1 root root  309 Apr  7 14:27 issue.yaml
-rw-rw-r--  1 root root  139 Apr  7 14:27 security_context.sh
root@master:~/kubernetes-like-a-pro/troubleshoot-kubernetes-like-a-pro/scenarios/security-context-issues# cat fix.yaml
apiVersion: v1
kind: Pod
metadata:
  name: security-context-fixed-pod
spec:
  containers:
  - name: busybox
    image: busybox
    command:
      - "sh"
      - "-c"
      - "echo 'Security context fixed' && sleep 1000"
  securityContext:
    runAsUser: 1000  # Set to a non-root user
    runAsGroup: 1000
root@master:~/kubernetes-like-a-pro/troubleshoot-kubernetes-like-a-pro/scenarios/security-context-issues# cat issue.yaml
apiVersion: v1
kind: Pod
metadata:
  name: security-context-issue-pod
spec:
  containers:
  - name: busybox
    image: busybox
    command:
      - "sh"
      - "-c"
      - "echo 'Simulating security context issue' && sleep 1000"
  securityContext:
    runAsUser: 0  # Simulating root user
    runAsGroup: 0

对比问题前yaml文件和修复后yaml文件

排查出是securityContext字段发生了变化,从0(root)用户切换到1000(普通用户)

实践:
	1.查看pod的用户是啥
	root@master:~/kubernetes-like-a-pro/troubleshoot-kubernetes-like-a-pro/scenarios/security-context-issues# kubectl exec -it security-context-issue-pod -- bin/sh
/ # id
uid=0(root) gid=0(root) groups=0(root),10(wheel)

	2.修改后pod的用户
	root@master:~/kubernetes-like-a-pro/troubleshoot-kubernetes-like-a-pro/scenarios/security-context-issues# kubectl exec -it security-context-fixed-pod -- bin/sh
~ $ id
uid=1000 gid=1000 groups=1000
6.CGroup问题
1.查看pod状态
root@master:~# kubectl get pods -o wide
NAME               READY   STATUS             RESTARTS   AGE     IP            NODE      NOMINATED NODE   READINESS GATES
cgroup-issue-pod   0/1     ImagePullBackOff   0          2m17s   10.244.2.23   worker2   <none>           <none>

这里的报错信息并不对,是我网络的问题造成的镜像拉取失败,正确的报错关键字应该是`OOMKilled`,`Exit Code: 137`,pod状态为CrashLoopBackOff或者Error


2.查看详细信息
Events:
  Type     Reason     Age                 From               Message
  ----     ------     ----                ----               -------
  Normal   Scheduled  111s                default-scheduler  Successfully assigned default/cgroup-issue-pod to worker2
  Normal   Pulling    17s (x4 over 110s)  kubelet            Pulling image "polinux/stress"
  Warning  Failed     16s (x4 over 109s)  kubelet            Failed to pull image "polinux/stress": failed to pull and unpack image "docker.io/polinux/stress:latest": failed to resolve image: unexpected status from HEAD request to https://docker.m.daocloud.io/v2/polinux/stress/manifests/latest?ns=docker.io: 403 Forbidden
denied: 🚫 👀-> https://github.com/DaoCloud/public-image-mirror/issues/2328 🔗 这镜像不在白名单. this image is not in the allowlist.
  Warning  Failed   16s (x4 over 109s)  kubelet  Error: ErrImagePull
  Normal   BackOff  3s (x6 over 109s)   kubelet  Back-off pulling image "polinux/stress"
  Warning  Failed   3s (x6 over 109s)   kubelet  Error: ImagePullBackOff

  核心错误。表示请求被服务器拒绝,场景,镜像不在白名单中

3.看出对应资源清单
root@master:~# cat ./kubernetes-like-a-pro/troubleshoot-kubernetes-like-a-pro/scenarios/cgroup-issues/issue.yaml
apiVersion: v1
kind: Pod
metadata:
  name: cgroup-issue-pod
spec:
  containers:
  - name: stress
    image: polinux/stress
    command: ["stress", "--vm", "1", "--vm-bytes", "100M"]
    resources:
      limits:
        memory: "50Mi"

可以看到容器启动使用内存为100m,但是limits限制的内存为50m,所以容器一达到50mi就被杀死
7.资源限制失败
1.查看pod信息
root@master:~# kubectl get pods -o wide
NAME                         READY   STATUS             RESTARTS   AGE   IP            NODE      NOMINATED NODE   READINESS GATES
failed-resource-limits-pod   0/1     ImagePullBackOff   0          16s   10.244.2.31   worker2   <none>           <none>

2.查看详细信息
Events:
  Type     Reason     Age                From               Message
  ----     ------     ----               ----               -------
  Normal   Scheduled  55s                default-scheduler  Successfully assigned default/failed-resource-limits-pod to worker2
  Normal   BackOff    25s (x2 over 53s)  kubelet            Back-off pulling image "polinux/stress"
  Warning  Failed     25s (x2 over 53s)  kubelet            Error: ImagePullBackOff
  Normal   Pulling    14s (x3 over 55s)  kubelet            Pulling image "polinux/stress"
  Warning  Failed     13s (x3 over 53s)  kubelet            Failed to pull image "polinux/stress": failed to pull and unpack image "docker.io/polinux/stress:latest": failed to resolve image: unexpected status from HEAD request to https://docker.m.daocloud.io/v2/polinux/stress/manifests/latest?ns=docker.io: 403 Forbidden
denied: 🚫 👀-> https://github.com/DaoCloud/public-image-mirror/issues/2328 🔗 这镜像不在白名单. this image is not in the allowlist.
  Warning  Failed  13s (x3 over 53s)  kubelet  Error: ErrImagePull


报错关键字:Failed to pull image 可以判断出是镜像拉取失败

3.找到pod对应yaml文件排查


未解决
8.存活探针失败

可以看到pod已经重启过一次

2.查看详细信息
kubectl describe pods liveness-probe-failure-pod

Events:
  Type     Reason     Age               From               Message
  ----     ------     ----              ----               -------
......
  Warning  Unhealthy  0s (x8 over 27s)  kubelet            Liveness probe failed: HTTP probe failed with statuscode: 404
.....

根据告警,可以得知是存活探针的问题


3.查看pod的yaml资源清单
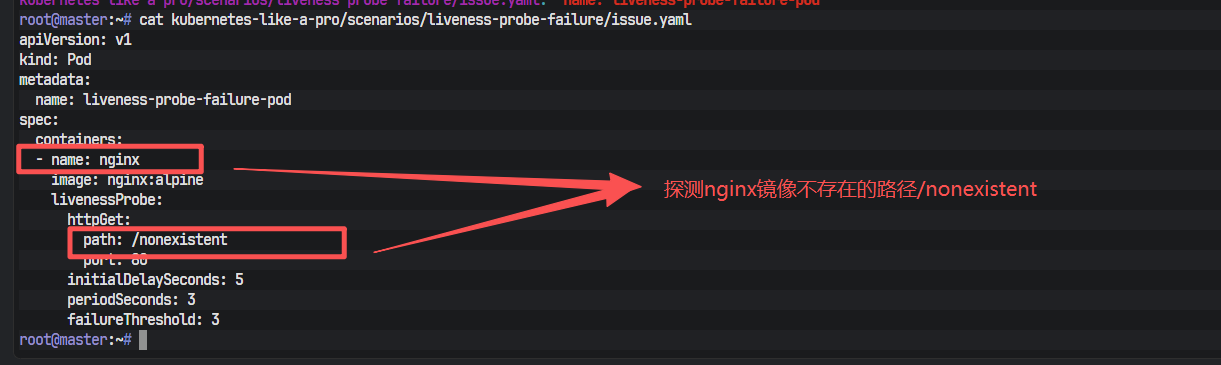
所有pod会一直进行重启

4.修改对应pod的资源清单,改成有相应路径的yaml后,删除并重启pod,就无报错
9.持久卷声明问题
1.查看详细报错信息
Events:
  Type     Reason            Age   From               Message
  ----     ------            ----  ----               -------
  Warning  FailedScheduling  61s   default-scheduler  0/3 nodes are available: pod has unbound immediate PersistentVolumeClaims. preemption: 0/3 nodes are available: 3 Preemption is not helpful for scheduling.

  警告  调度器尝试将pod放在3个节点上失败,pod未绑定pvc

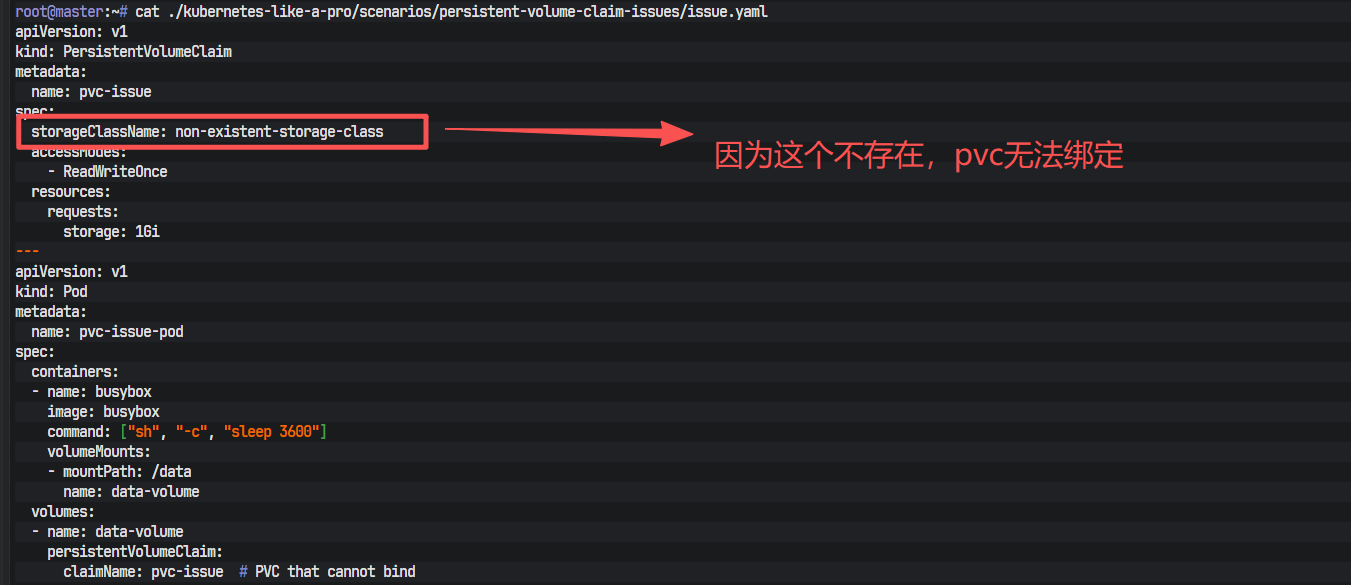
2.查看对应pod的yaml清单
root@master:~# grep -r "name: pvc-issue-pod" .
./kubernetes-like-a-pro/scenarios/persistent-volume-claim-issues/issue.yaml:  name: pvc-issue-pod
10.SELinux/AppArmor 策略冲突
11.集群自动伸缩问题
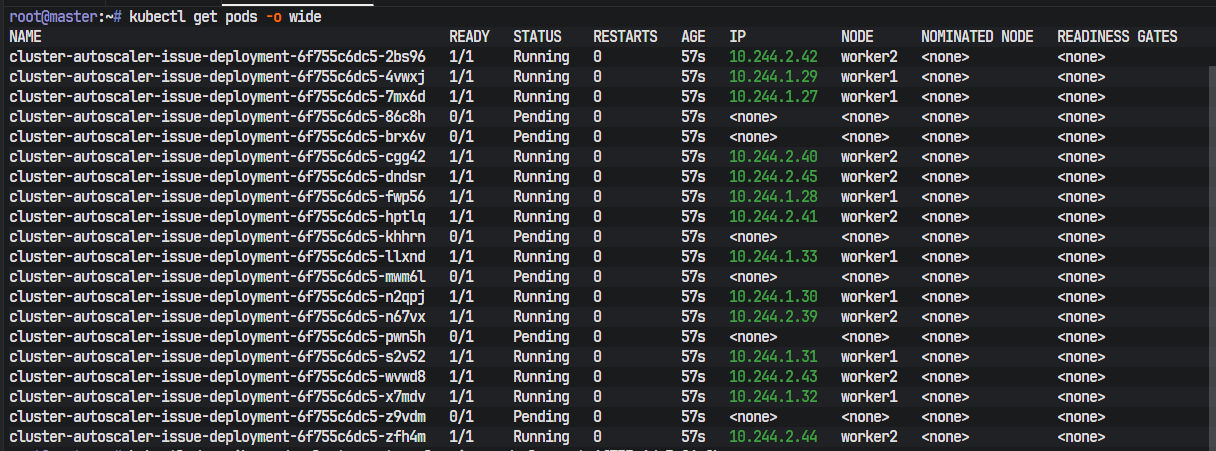
发现有多个pod状态处于pending状态

2.查看pod的详细信息
Events:
  Type     Reason            Age   From               Message
  ----     ------            ----  ----               -------
  Warning  FailedScheduling  90s   default-scheduler  0/3 nodes are available: 1 node(s) had untolerated taint {node-role.kubernetes.io/control-plane: }, 2 Insufficient cpu. preemption: 0/3 nodes are available: 1 Preemption is not helpful for scheduling, 2 No preemption victims found for incoming pod.

  警告   调度失败  90s前  来自默认调度器  可用节点0/3: 1个节点存在不可容忍的污点:node-role.kubernetes.io/control-plane:

  2个节点cpu不足,抢占评估结果:0/3节点可用,其中1个节点抢占无法解决调度问题,另外2个节点未找到可被抢占到pod

3.查看pod对应的资源清单
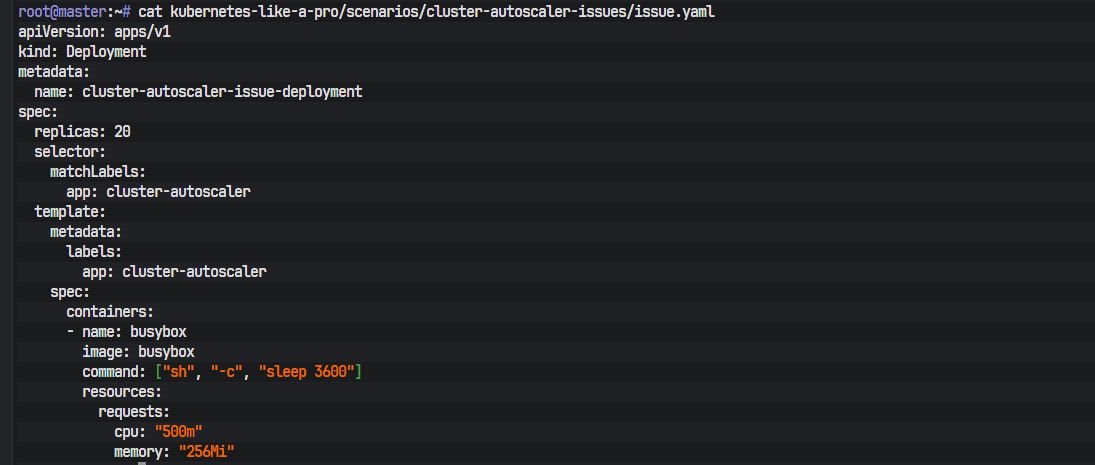
发现启动的pod配置信息为0.5核心256m的内存,启动20个pod
但是我1master2worker都是4h4g的内存,所以我的集群硬件条件无法满足启动20个pod,所以有的pod无法启动

解决办法:
	1.要么修改对应的pod配置
	2.要么减少启动的pod数量
12.挂载卷文件权限问题
1.查看pod状态为error状态

2.查看详细信息
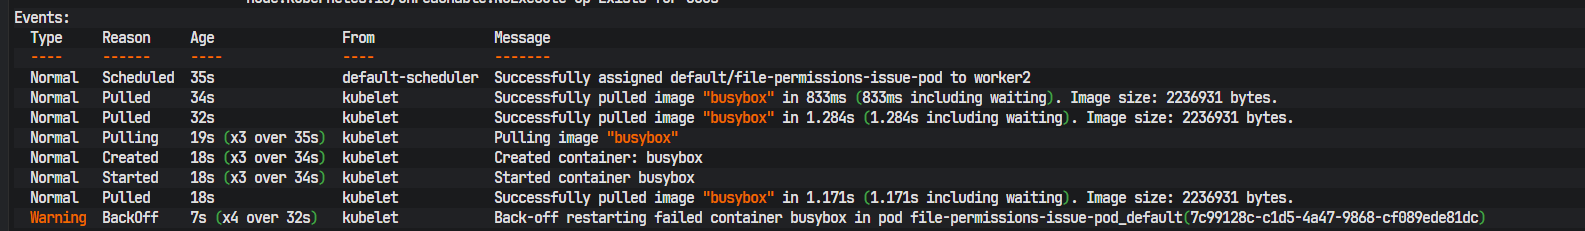
警告 回退重启 7s前 来自 kubelet 正在退避重启pod file-permissions-issue-pod(位于名称空间 default,UID为 7c99128...)中失败的容器 busybox

3.查看pod日志
root@master:~# kubectl logs file-permissions-issue-pod
sh: line 0: can't create /tmp/test.txt: Read-only file system

无法创建/tmp/test.txt'

4.查看pod的yaml清单
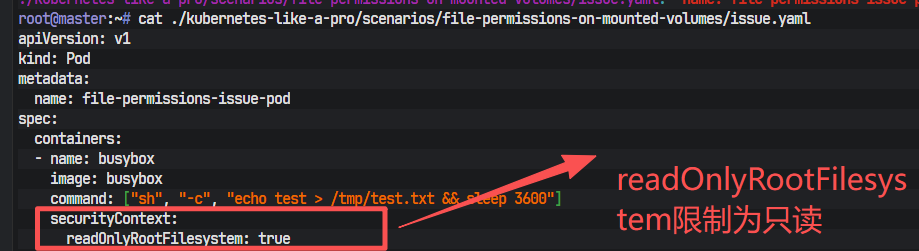
发现是限制了只读,注解或者删除securityContext字段就可以了
13.存活/就绪探针失败
1.查看Pod状态
root@master:~# kubectl get pods -o wide
NAME                             READY   STATUS    RESTARTS      AGE   IP            NODE      NOMINATED NODE   READINESS GATES
liveness-readiness-failure-pod   0/1     Running   1 (12s ago)   24s   10.244.1.36   worker1   <none>           <none>

虽然状态为running状态,但是重启过一次

2.查看pod详细信息
Events:
  Type     Reason     Age                From               Message
  ----     ------     ----               ----               -------
  Warning  Unhealthy  5s (x12 over 36s)  kubelet            Readiness probe failed: HTTP probe failed with statuscode: 404
  Warning  Unhealthy  5s (x9 over 35s)   kubelet            Liveness probe failed: HTTP probe failed with statuscode: 404
  警告 不健康 5s(在36s内出现12次) kubelet 就绪探针失败:http探测失败,状态码为404
  警告 不健康 5s(在35s内出现9次) kubelet 存活探针失败:http探测状态,状态码为404

3.查看对应pod的yaml文件
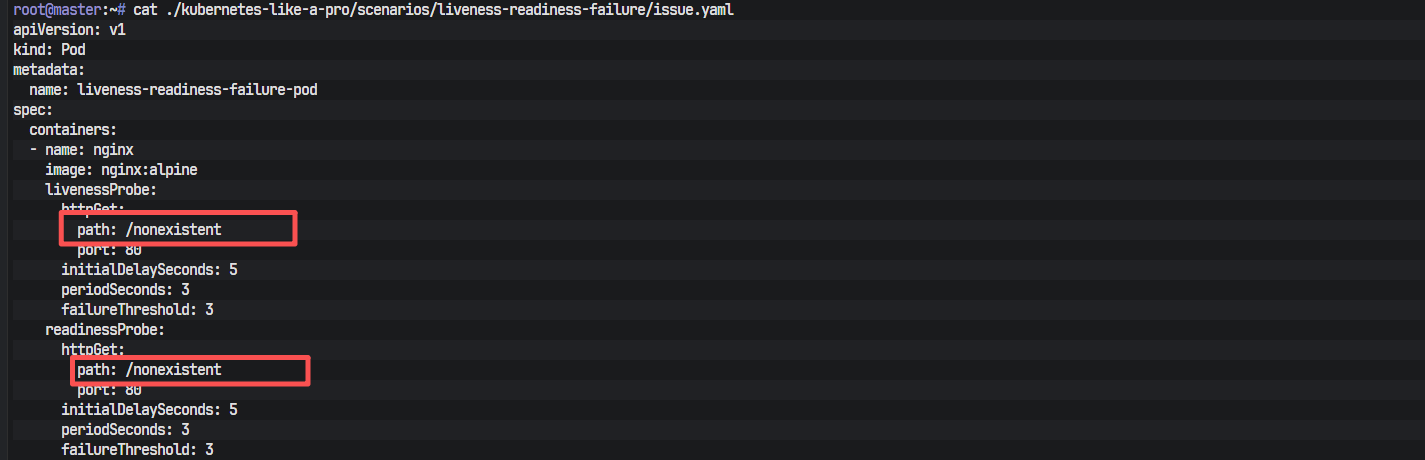
可以看到yaml文件中的存活探针和就绪探针都需要存在/nonexistent文件夹才能通过探针,但是nginx默认没有这个文件,所以探针失败,将标红的这两个删除后,重启pod,现在正常
14.PID命明空间冲突
root@master:~# kubectl get pod pid-namespace-collision-pod -o yaml | grep -E "hostPID|shareProcessNamespace"
      {"apiVersion":"v1","kind":"Pod","metadata":{"annotations":{},"name":"pid-namespace-collision-pod","namespace":"default"},"spec":{"containers":[{"command":["sh","-c","echo 'WARNING: Host PID namespace shared - security risk' \u0026\u0026 sleep 3600"],"image":"busybox","name":"busybox","securityContext":{"runAsUser":1000}}],"hostPID":true}}
  hostPID: true

查看pod的yaml文件,该pod共享宿主机pid命名空间

后果:
	1.进入pod内可以执行ps aux可以看到宿主机的全部进程
	2.如果pod内的应用被攻破,可以使用kill -9 杀死宿主机上的进程
	3.当pid资源全局耗尽后,节点上的所以pod都无法创建新进程
15.ServiceAccount权限问题
16.容器运行时(CRI)错误
1.查看pod状态
root@master:~# kubectl get pods -o wide
NAME            READY   STATUS              RESTARTS   AGE   IP       NODE      NOMINATED NODE   READINESS GATES
cri-error-pod   0/1     ContainerCreating   0          59s   <none>   worker2   <none>           <none>

pod状态被卡到containerCreating 容器创建中

2.查看pod详细状态信息
Events:
  Type     Reason                  Age   From               Message
  ----     ------                  ----  ----               -------
  Normal   Scheduled               104s  default-scheduler  Successfully assigned default/cri-error-pod to worker2
  Warning  FailedCreatePodSandBox  104s  kubelet            Failed to create pod sandbox: rpc error: code = Unknown desc = unable to get OCI runtime for sandbox "c1d55779fc3edbd434abb06b671c048441fc59230848f785b9615edf26e30a4c": no runtime for "non-existent-handler" is configured
  警告 创建pod沙盒失败 104s前 来自kubelet 创建pod沙盒失败,错误码=Unknown,描述 = 无法为沙盒 c1.... 获取oci运行时:未配置名为non-existent-handler的运行时


3.查看对应pod的yaml文件
root@master:~# cat ./kubernetes-like-a-pro/scenarios/container-runtime-cri-errors/issue.yaml
apiVersion: node.k8s.io/v1
kind: RuntimeClass
metadata:
  name: broken-runtime
handler: non-existent-handler
---
apiVersion: v1
kind: Pod
metadata:
  name: cri-error-pod
spec:
  runtimeClassName: broken-runtime
  containers:
  - name: busybox
    image: busybox
    command: ["sh", "-c", "sleep 3600"]


handler字段指定了容器运行时的处理名称,用于告知kubelet应用使用那个具体的OCI(Open Container lnitiative)运行时来运行该pod的容器

可以看到yaml文件中配置了non-existent-handler,所以和报错信息相对应,没有对应的non-existent-handler运行时,所以无法启动pod

4.确定从节点部署了哪些handler
cat /etc/containerd/config.toml | grep -A 10 "runtimes"

可能会看到类似下面的内容:
	root@worker2:~# cat /etc/containerd/config.toml | grep -A 10 "runtimes"
      [plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes]
        [plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.runc]
          runtime_type = 'io.containerd.runc.v2'
          runtime_path = ''
          pod_annotations = []
          container_annotations = []
          privileged_without_host_devices = false
          privileged_without_host_devices_all_devices_allowed = false
          cgroup_writable = false
          base_runtime_spec = ''
          cni_conf_dir = ''
          cni_max_conf_num = 0
--
          [plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.runc.options]
            BinaryName = ''
            CriuImagePath = ''
            CriuWorkPath = ''
            IoGid = 0
            IoUid = 0
            NoNewKeyring = false
            Root = ''
            ShimCgroup = ''
            SystemdCgroup = true


其中这两行是关键:
	[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.runc]
	[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.runc.options]

	这两行配置位于containerd的配置文件(通常在/etc/containerd/config.toml)中,定义并配置runc这个运行时常量区(handler)的核心部分
17.防火墙限制
通过17个案例后,通用的三步走应该很熟练了:
	kubectl get nodes -o wide
	kubectl get pods -o wide
	kubectl describe pods <pod-name>
	kubectl logs <pod-name>

1.前面都没有问题,查看pod的log日志出现问题
root@master:~# kubectl logs firewall-restriction-pod
wget: download timed out
blocked

wget下载超时


2.进入pod检查dns解析